必须移除敏感信息时,选择可行路径
有可编辑的原始文档
- 在原件副本中删除敏感文字或图像本身。仅隐藏或改变显示范围不够。检查批注、修订历史、附件和文档属性中是否也有相同信息。
- 从清理后的原件生成新 PDF,另存为独立文件。检查所有页面、附件、注释、文档属性和可提取文字。重新导出本身不能保证彻底删除。
只有 PDF,无法重建
- 你需要的是 PDF 数据删除操作,而不是绘图或遮盖工具。先查具体产品及版本的官方文档:必须能实际应用数据删除,并提供隐藏信息检查。
- 区分标记删除区域和实际执行删除,把结果与原件分别保存。关闭并重开,检查页面显示、搜索、复制、提取、附件、注释与元数据。
- 文字搜索可能找不到图片或扫描中的敏感信息。不能执行必要检查,或信息仍残留时,请暂缓发送,向作者索取清理后的副本。
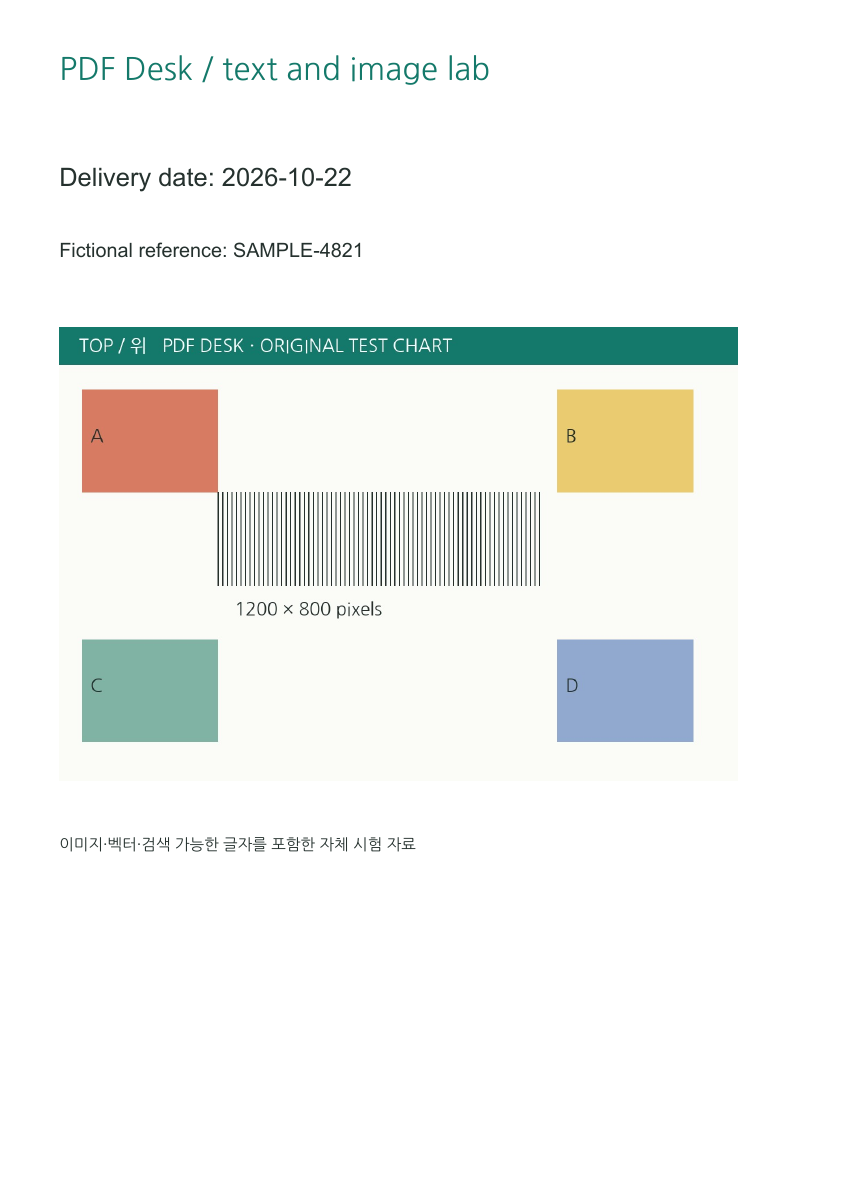
本次测量证明虚构编号在覆盖和裁剪后仍存在。我们没有运行特定安全删除产品,也未验证任何已脱敏输出。这些步骤不证明所有隐藏数据通道都已清除,搜索失败也不代表安全。我们未确认外部工具的费用、版本或上传方式:请查官方文档,先用虚构材料测试,不要直接使用敏感文件。
两种隐藏方式
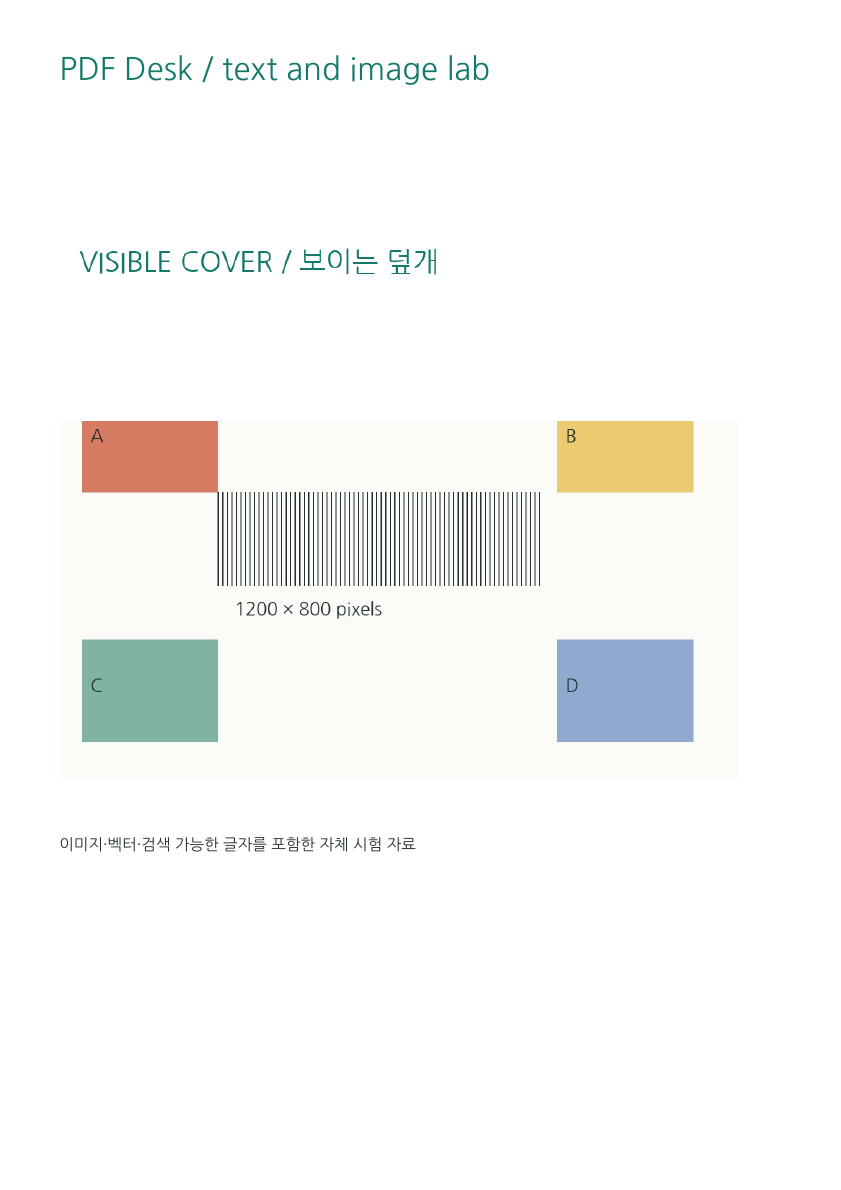
一份输出用 PDF Desk 引擎添加不透明图片;另一份独立试验降低 CropBox 顶边,隐藏日期和编号。裁剪不是应用功能,PDF Desk 会阻止编辑非标准 CropBox 文档。
实际观察事实
pypdf 从两份文件都提取出 SAMPLE-4821。看起来干净的页面仍含原文。Adobe 也区分隐藏页面区域与删除其中数据。文件更小或搜索不到,单独都不能证明完全清除。
自行复现此失败结果
- 请用下方虚构原件,不要用敏感资料。先找到其中的编号。
- 打开覆盖与裁剪结果,对比同一可见区域。
- 在各输出中搜索或复制编号,对照独立提取结果。阅读器找不到,也不能据此认定已删除。
产品功能边界
PDF Desk 不提供安全删除。新增文字、图片、边框或制作器的“填充”模式都不是隐私清除。本试验检测到原文残留,但不是对所有隐藏数据通道的全面审计。
可下载检查的文件
独立观察结果与方法(JSON) · 作者信息与文件哈希截取坐标、比例、源文件哈希与重新提取结果 · 复核:2026-10-24 · pdftoppm 26.07.0 · pypdf 6.10.0 · pdfplumber 0.11.9。原始 PDF 未修改。
环境、日期与证据范围
检查日期:2026-10-23 · Windows / Chrome 155 · pdf-lib 1.17.1 · PDF.js 6.4.299 · fontkit 1.1.1 · pypdf 6.10.0 · pdftoppm 26.07.0。PDF 和图形为原创;NanumGothic 采用 OFL-1.1。表格和文件记录直接观察结果,说明文字解释其结构。真实操作系统键盘输入、实体手机及所有 PDF 阅读器不在本次试验范围内。
官方参考说明(与实测结果分开): Adobe:裁剪隐藏内容,而不删除数据
复现代码:scripts/lab-inputs.py、lab-outputs.mjs、lab-derived.py、tests/readiness-browser.mjs 和 tests/lab-pdf.py。